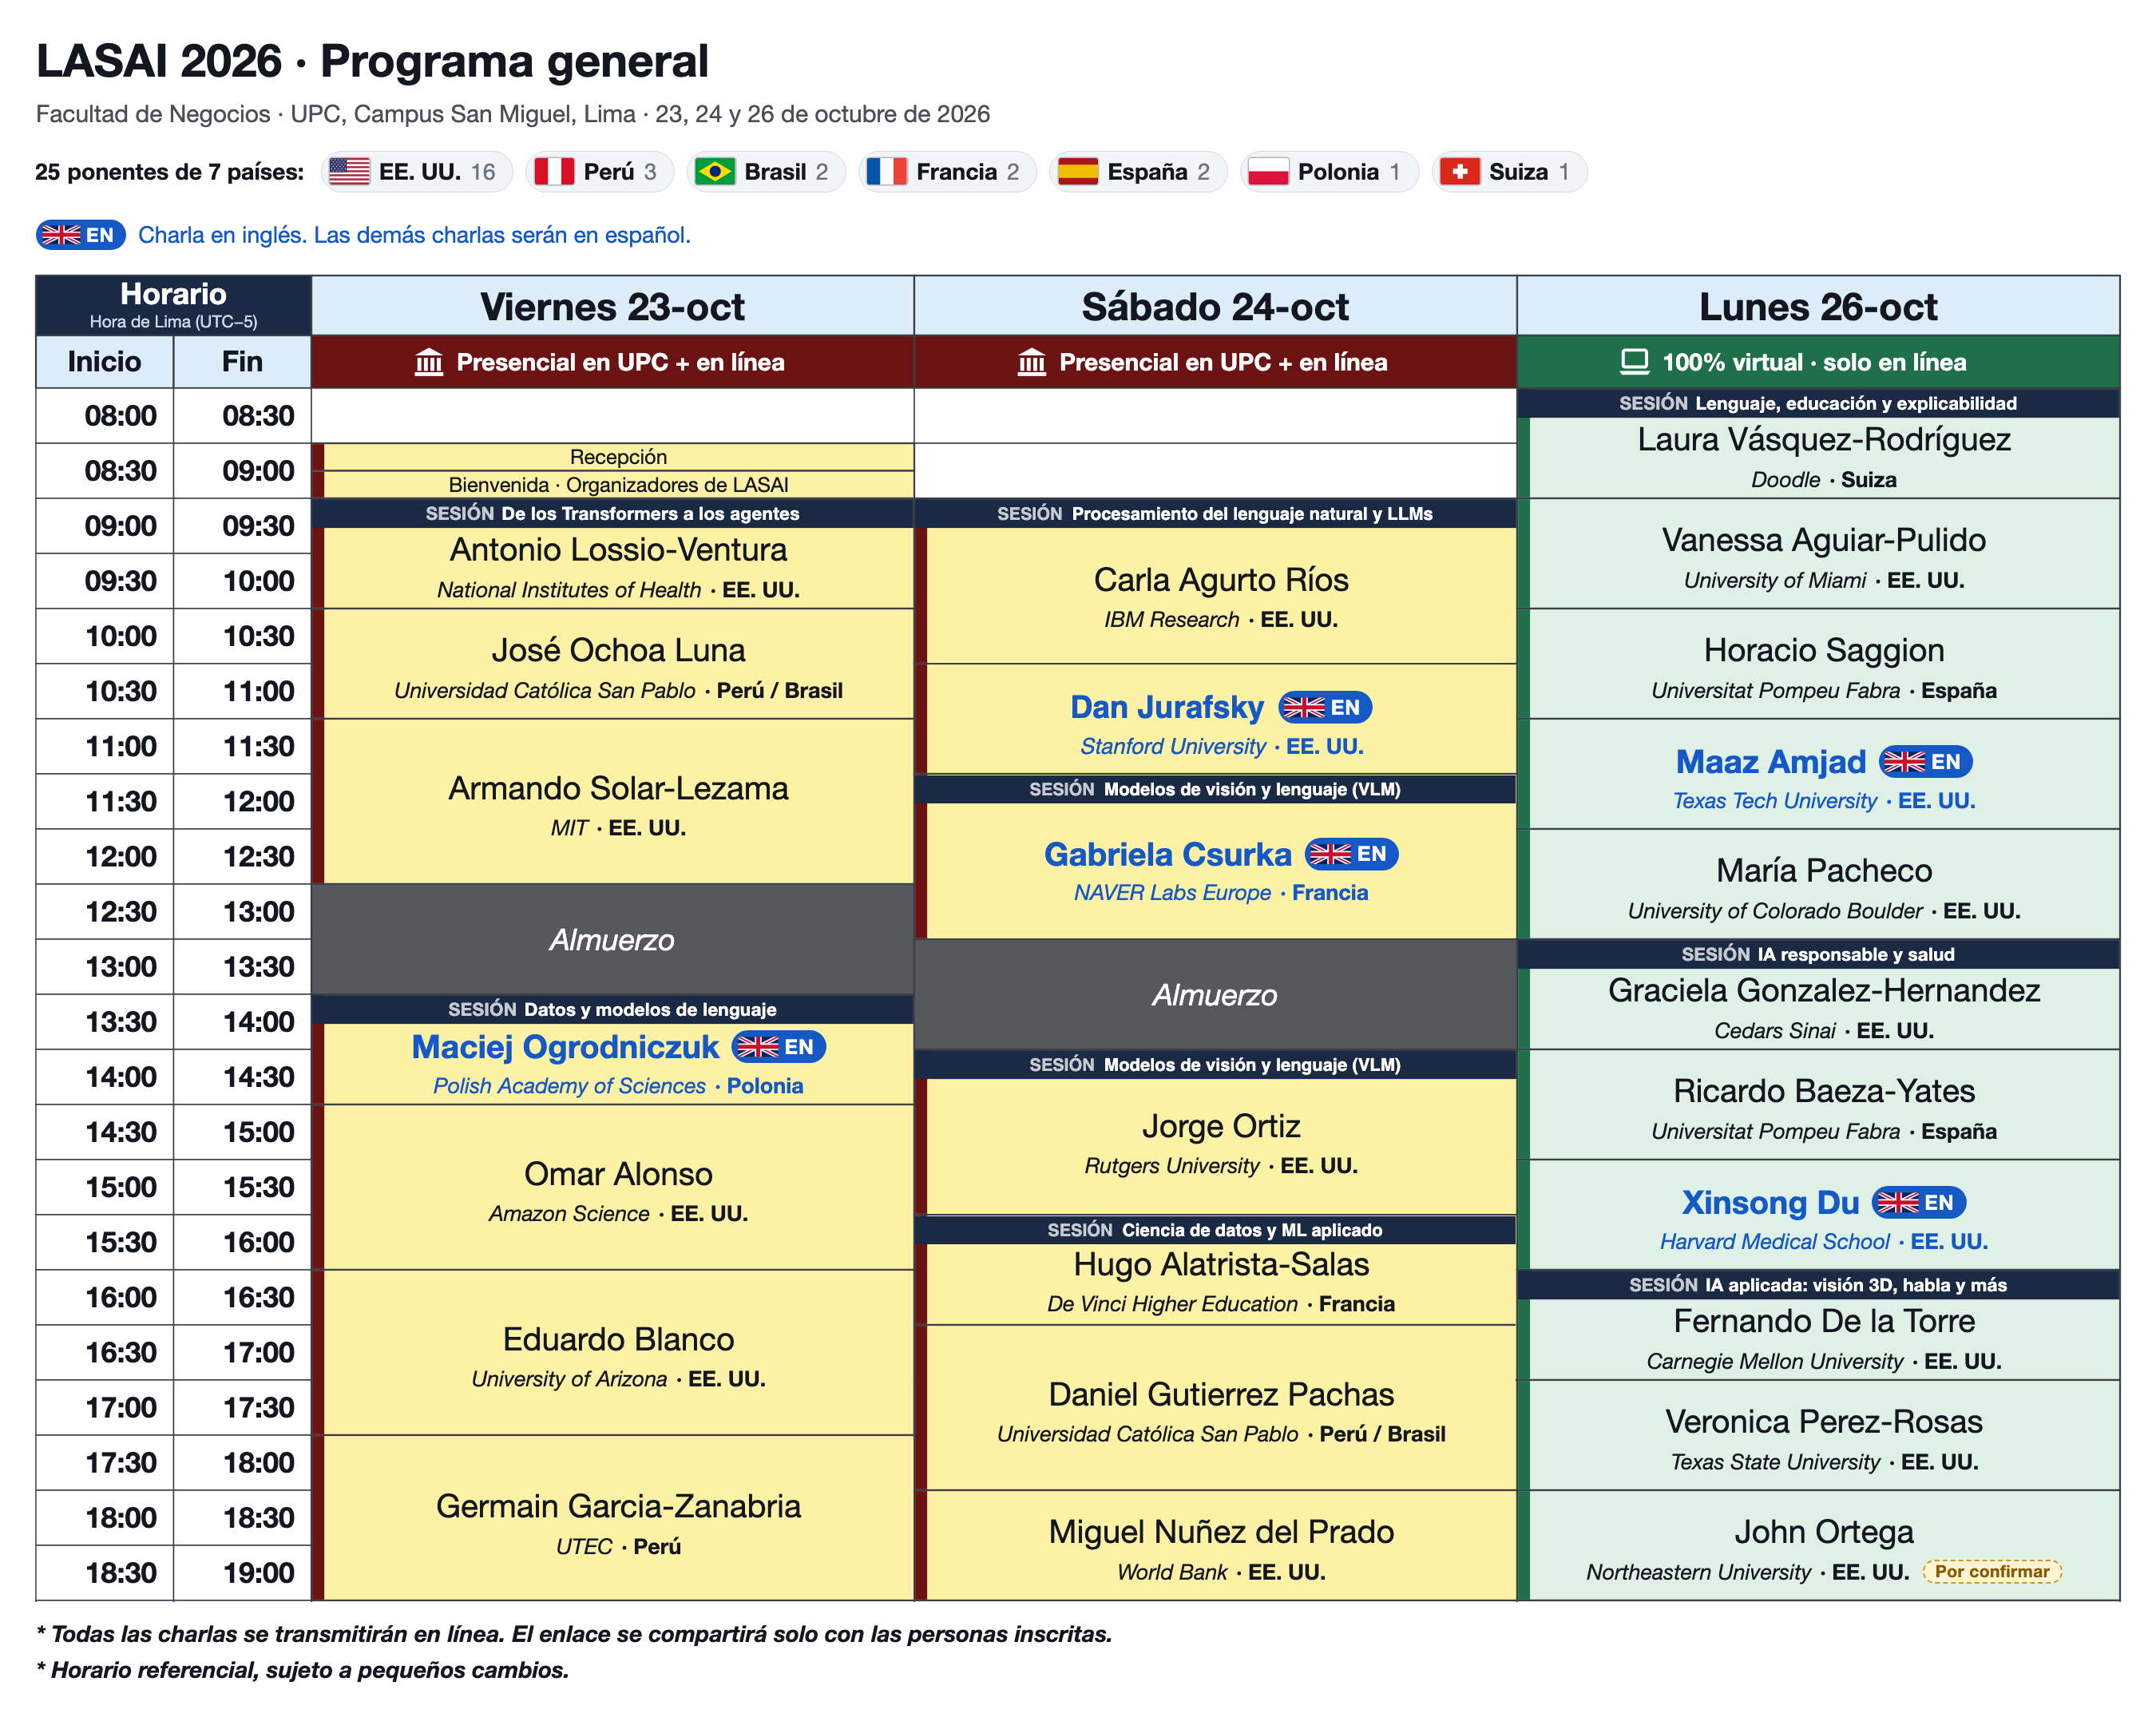
Viernes 23 de octubre
Híbrido · Presencial + virtualSesión de la mañanaDe los Transformers a los agentes 09:00 – 12:30
Total de la sesión: 3 h 30 min · 3 presentaciones| Hora | Ponente | Presentación | Idioma |
|---|---|---|---|
| 09:00 – 10:001 h | Antonio Lossio-VenturaNational Institutes of Health, USA | Transformers: Arquitectura y funcionamientoResumenEsta presentación ofrece una introducción a la arquitectura Transformer, base de los modelos de lenguaje modernos (Large Language Models, LLM). Se explicarán sus principales componentes, como los mecanismos de atención, las codificaciones posicionales y las redes neuronales, para comprender cómo procesan y representan la información. Finalmente, se introducirán sus aplicaciones en modelos multimodales capaces de integrar texto e imágenes. |
ES Español |
| 10:00 – 11:001 h | José Ochoa LunaUniversidad Católica San Pablo, Peru | Fine-tuning SLMs y su aplicación en AgentesResumenSe presentará la evolución de las diversas técnicas de fine-tuning en LLMs, su relevancia en el desarrollo de SLMs y su aplicación en el desarrollo de agentes inteligentes que realizan tareas al llamar funciones. |
ES Español |
| 11:00 – 12:301 h 30 min | Armando Solar-LezamaMIT (Massachusetts Institute of Technology), USA | Modelos, Agentes, y todo lo que necesitas para diseñar sistemas de IAResumenEsta presentación ofrecerá una introducción a los principales componentes y herramientas para diseñar sistemas de inteligencia artificial, desde los modelos de lenguaje hasta los agentes inteligentes. Se explorará cómo estos elementos se integran para desarrollar sistemas capaces de razonar, utilizar herramientas y ejecutar tareas de forma autónoma, destacando sus aplicaciones y los aspectos clave para su diseño e implementación. |
ES Español |
Sesión de la tardeDatos y modelos de lenguaje 13:30 – 19:00
Total de la sesión: 5 h 30 min · 4 presentaciones| Hora | Ponente | Presentación | Idioma |
|---|---|---|---|
| 13:30 – 14:301 h | Maciej OgrodniczukInstitute of Computer Science, Polish Academy of Sciences, Poland | Building PLLuM -- The Polish Large Language ModelResumenThis talk introduces PLLuM (Polish Large Language Model), a flagship open-source AI initiative funded by the Ministry of Digital Affairs of Poland. Developed by a including Polish universities, research institutes and computing centres, PLLuM advances the Polish AI ecosystem through a set of open-weight models ranging from 4B to 70B parameters across base, instruction-tuned and aligned chat variants. The presentation will focus on six key areas of PLLuM development: legal compliance with EU copyright and TDM regulations, methodological rigor, robust security and safety protocols, reliance on high-quality organic instruction data, user-centric public sector design and complete openness. To overcome model collapse, the initiative prioritizes manually curated instructions and human-preference alignment. Pre-training strategies encompass both models built entirely from scratch, such as a 24B parameter base, alongside strategic collaborations with Mistral AI. To ensure linguistic accuracy and reliable real-world usage, performance is benchmarked using tailored evaluation frameworks. These developments are intended to serve practical public sector applications, enabling domain-specific text simplification and real-world deployment within mObywatel – a free official mobile application and public service platform for Polish citizens. |
EN English |
| 14:30 – 16:001 h 30 min | Omar AlonsoAmazon Science, USA | Labeling and the creation of training setsResumenMany data intensive applications that use machine learning or artificial intelligence techniques depend on humans providing the initial dataset, enabling algorithms to process the rest or for other humans to evaluate the performance of such algorithms. LLMs are also being used for automating labeling at scale. However, building systems data processing pipelines that require human or machine labeling remains difficult. In this short tutorial, we present practical considerations for designing and implementing tasks that require the use of humans and machines in combination with the goal of producing high-quality labels for training sets. This tutorial will be given in Spanish. |
ES Español |
| 16:00 – 17:301 h 30 min | Eduardo BlancoUniversity of Arizona, USA | La negación en los modelos de lenguaje: limitaciones y estrategias de mejoraResumenLa negación está presente en todas las lenguas humanas y se considera un rasgo definitorio del lenguaje y de la cognición. Los modelos de lenguaje, desde las arquitecturas Transformer de generaciones anteriores hasta los modelos de lenguaje de gran tamaño más avanzados, suelen mostrar un rendimiento inferior al procesar textos que contienen negación. Esta limitación se observa en aplicaciones como la traducción automática, la respuesta a preguntas y la recuperación de información. En otras palabras, traducir oraciones con negación, responder preguntas que requieren razonar sobre textos que la incluyen y recuperar documentos relevantes a partir de consultas que la contienen suelen ser tareas más difíciles que sus equivalentes en ausencia de negación. En esta charla, presentaré el fenómeno de la negación y analizaré las limitaciones de los modelos de lenguaje al abordar problemas que requieren su compresión. A continuación, expondré varias estrategias diseñadas para mejorar la robustez de estos modelos frente a la negación. Dado que son independientes tanto del modelo como de la tarea, estas estrategias pueden aplicarse a cualquier modelo de lenguaje con el fin de mejorar su comprensión general de la negación, en lugar de limitar las mejoras a un modelo o a una tarea específicos. |
ES Español |
| 17:30 – 19:001 h 30 min | Germain Garcia-ZanabriaUniversidad de Ingeniería y Tecnología, Peru | Ciencia de datos y analítica visual para la toma de decisiones preventivas: aplicaciones en criminalidad urbana y deserción universitariaResumenLa ciencia de datos permite identificar patrones y anticipar fenómenos complejos. Sin embargo, una predicción por sí sola no siempre es suficiente para apoyar la toma de decisiones. En esta charla se presentarán dos aplicaciones de machine learning y analítica visual orientadas a la prevención. La primera aborda el análisis espacio-temporal de la criminalidad en grandes ciudades, incluyendo la detección de hotspots y el estudio de la relación entre los delitos y las características urbanas. La segunda se enfoca en la prevención de la deserción universitaria mediante herramientas visuales que combinan modelos predictivos, análisis de supervivencia y explicaciones contrafactuales. |
ES Español |